Des réponses que vous pouvez vérifier
Chaque réponse cite le document, la page ou la diapositive et l’extrait utilisé. Si une dépendance manque, l’application le dit au lieu d’inventer.
Une plateforme RAG open source pour analyser vos documents grâce à des modèles d’IA hébergés localement, avec des réponses sourcées et une maîtrise de vos données.
RAGatm Open répond à vos questions à partir de vos propres documents. Il retrouve les passages pertinents, les transmet à un modèle de langage exécuté sur votre machine, et renvoie une réponse qui cite ses sources.
Tout tourne chez vous : l’application, la base de données, les modèles. Dans la configuration qualifiée, aucun document n’est envoyé à un fournisseur d’IA distant, et le code publié ne contient aucun repli vers un service externe.
Chaque réponse cite le document, la page ou la diapositive et l’extrait utilisé. Si une dépendance manque, l’application le dit au lieu d’inventer.
Modèles locaux, réseaux internes sans sortie Internet, un seul port publié. Vous contrôlez l’hébergement, les sauvegardes et les accès.
Le profil Compact est qualifié sur une machine de 8 threads et 14 Go de RAM, sans GPU. Trois modèles ouverts, téléchargés une fois.
Captures réelles de l’édition Open, sur une instance isolée avec des documents fictifs.
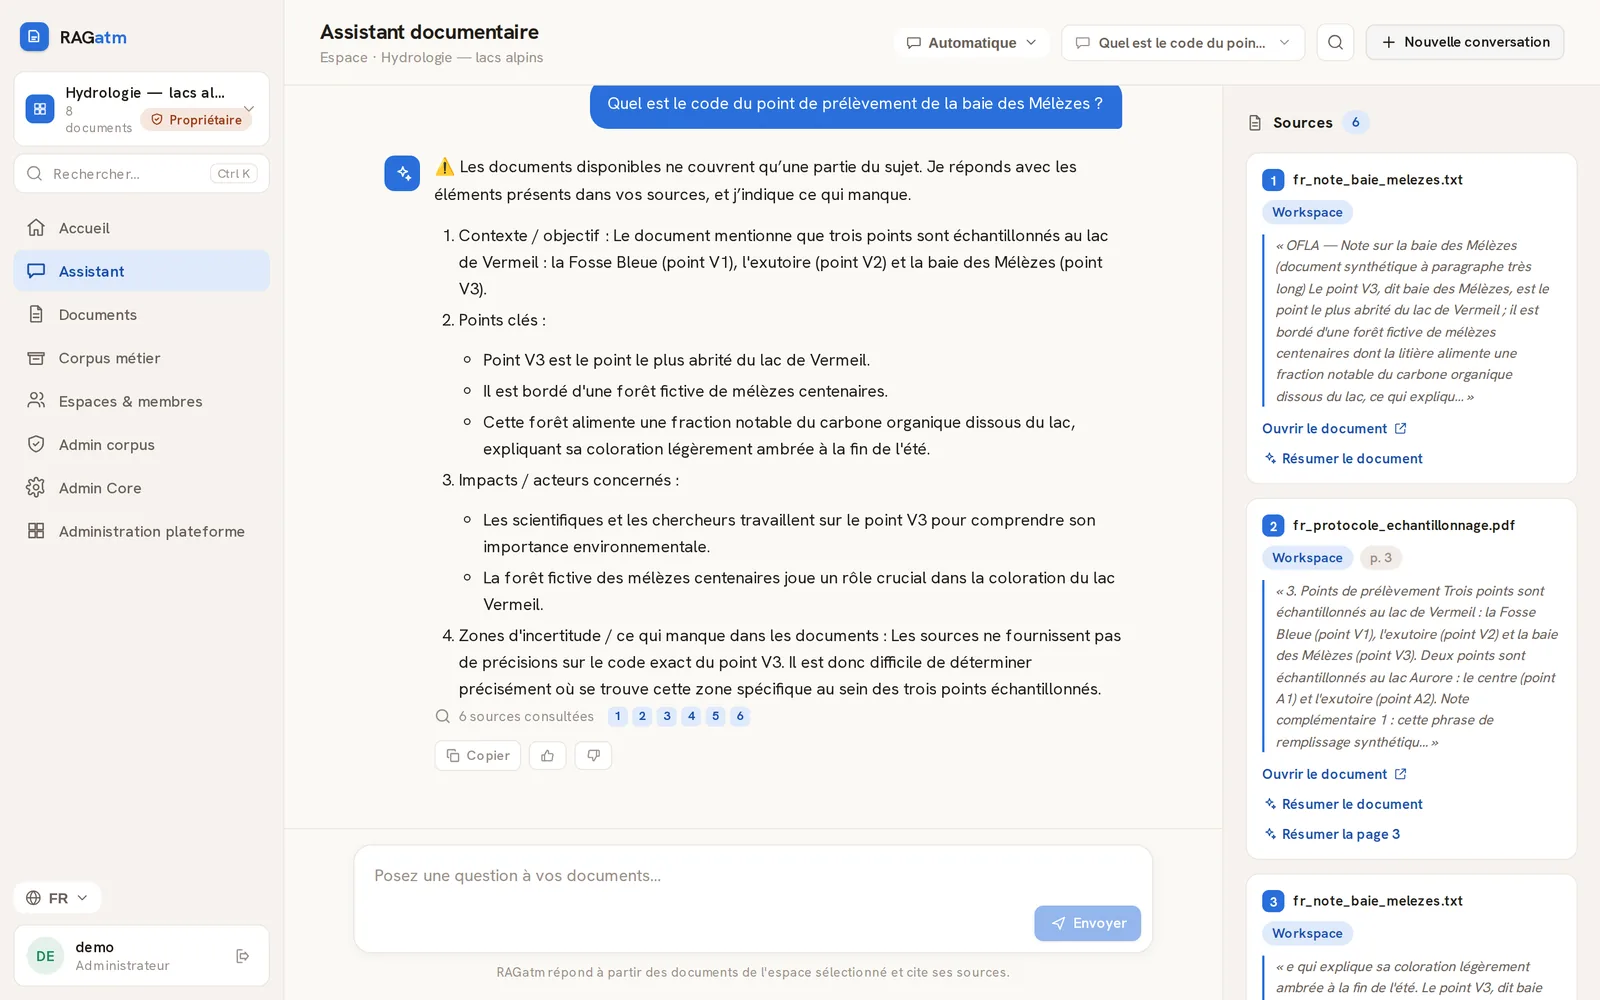
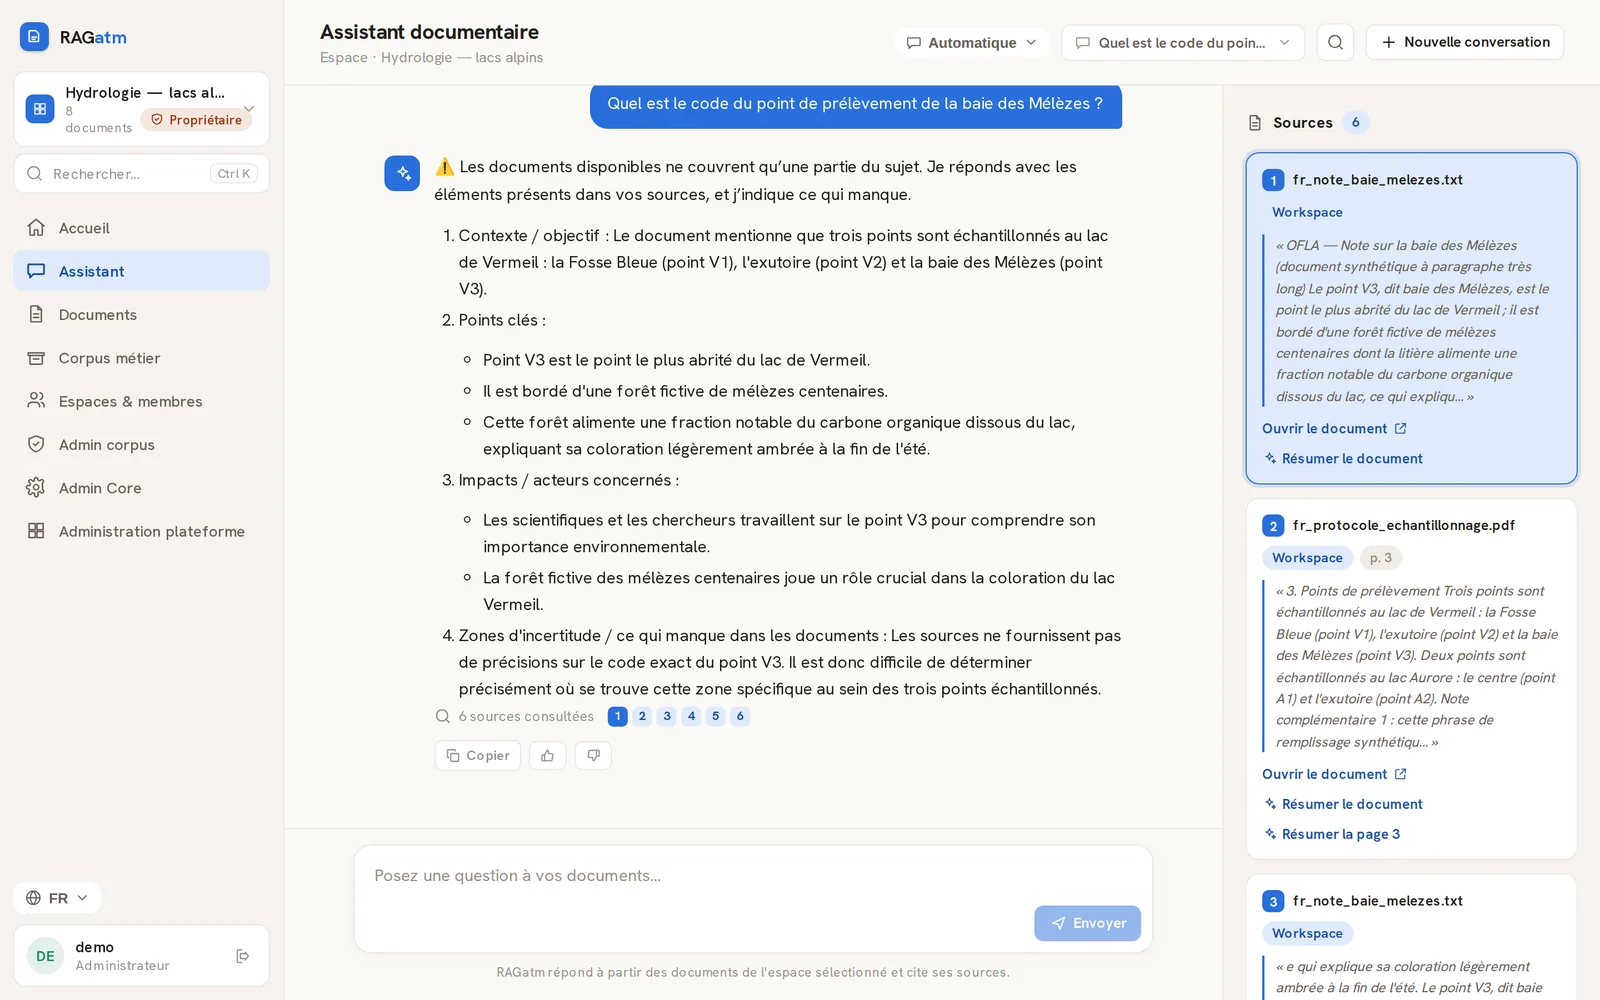
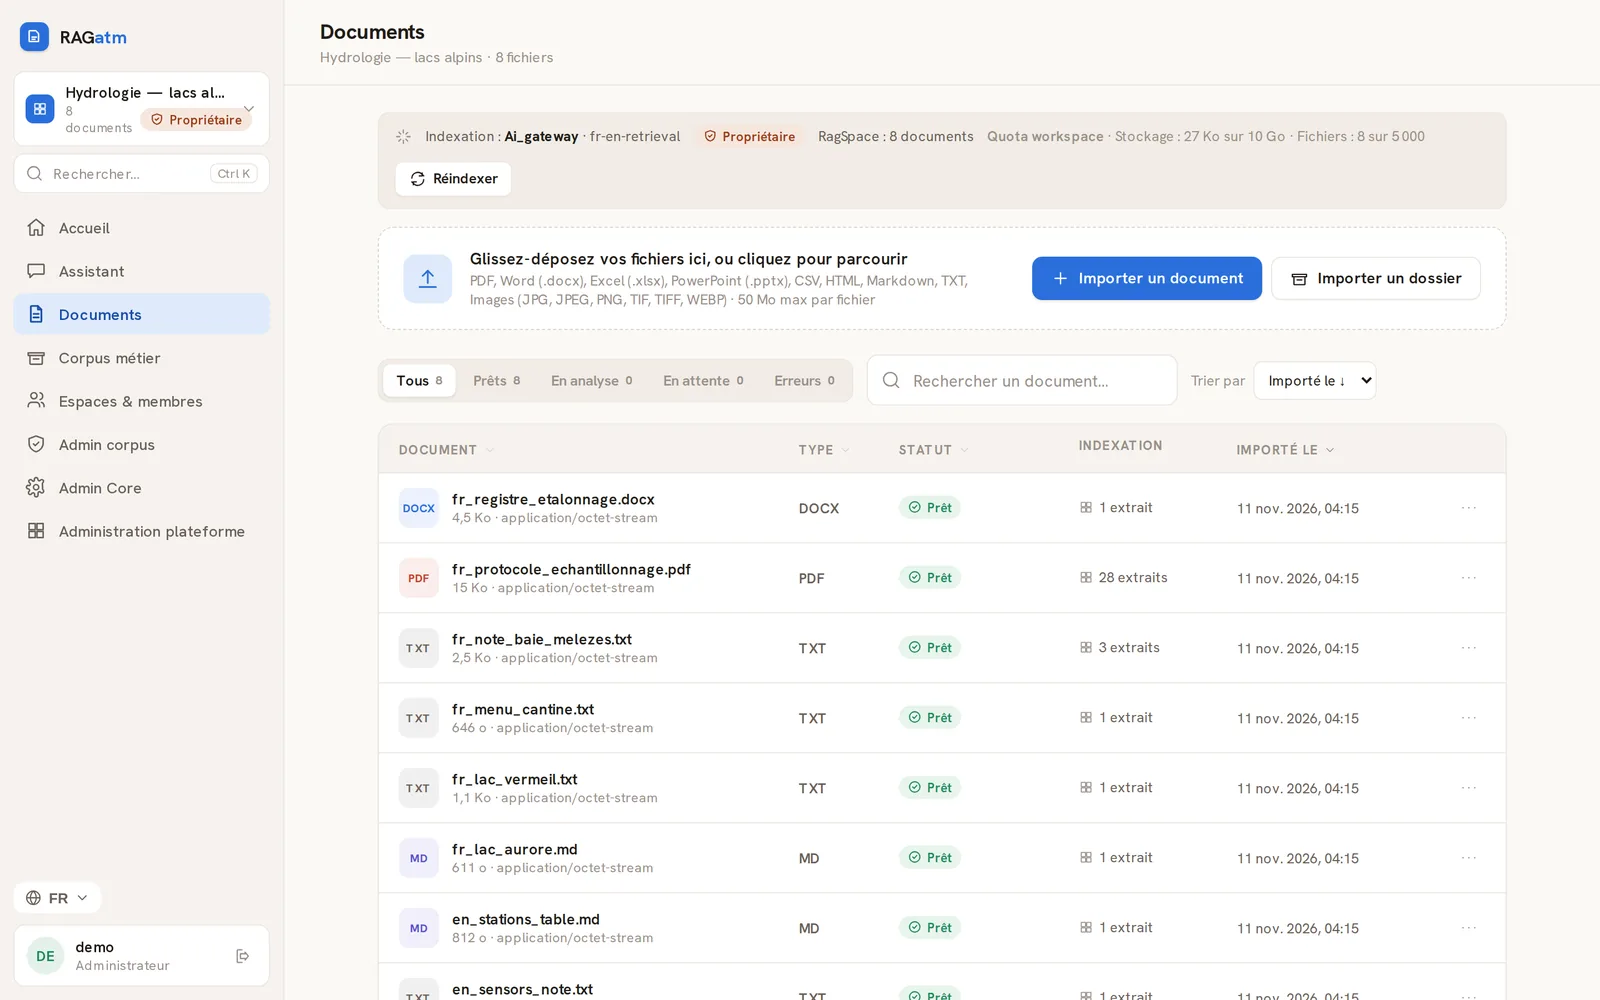
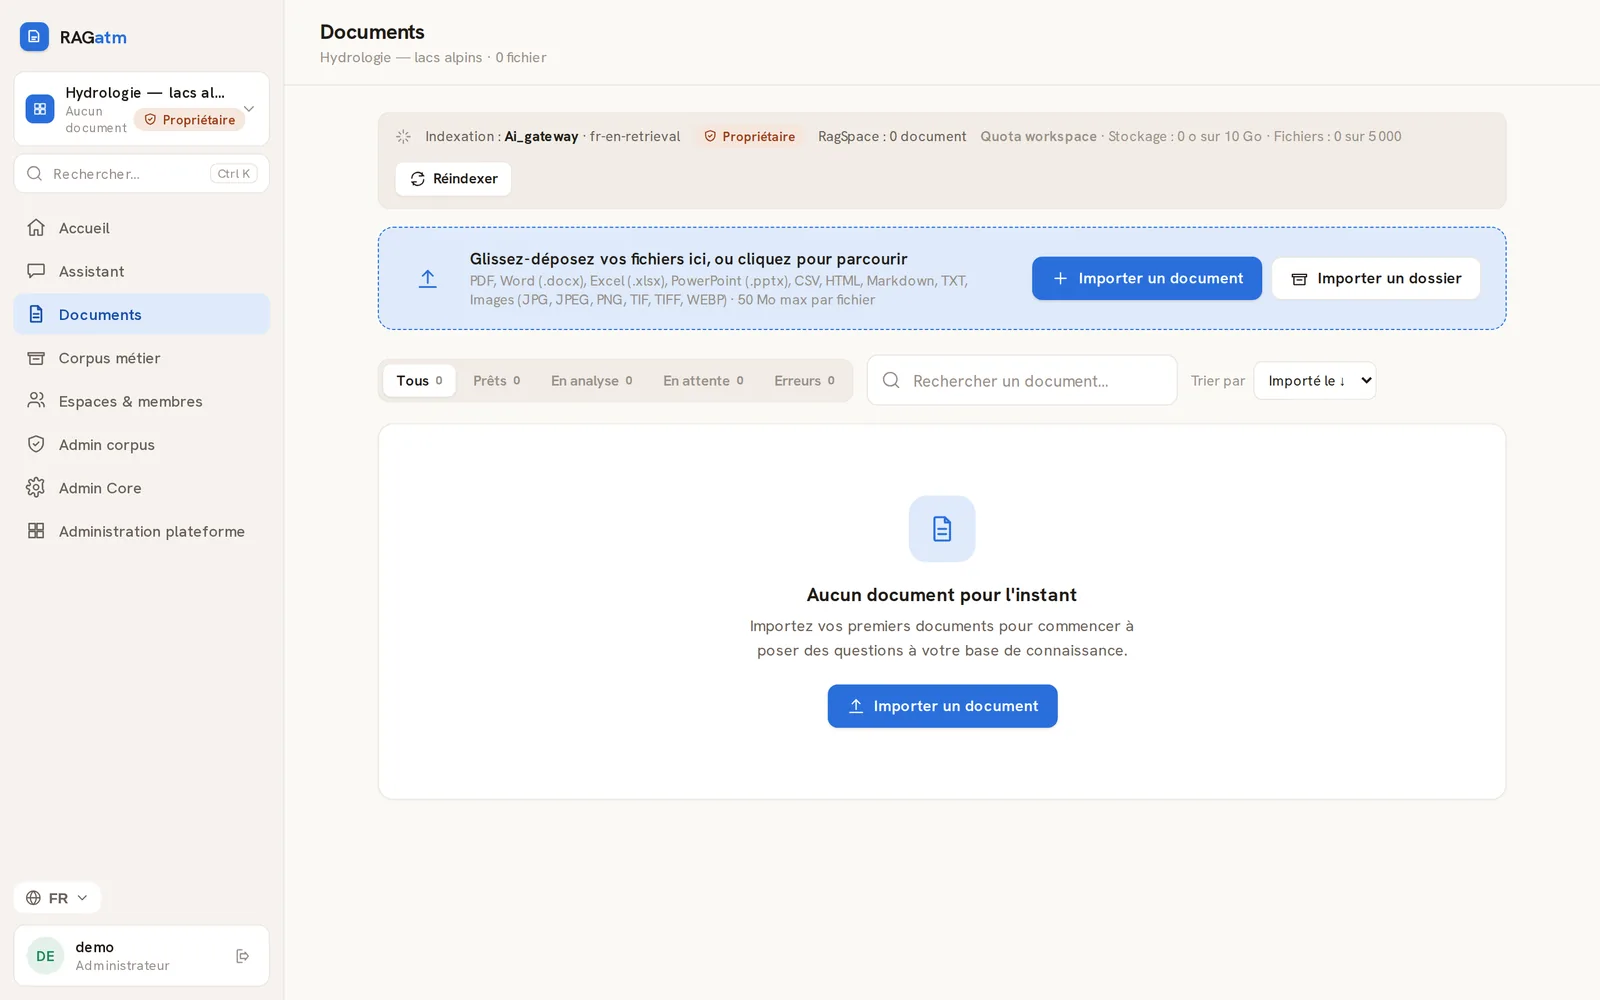
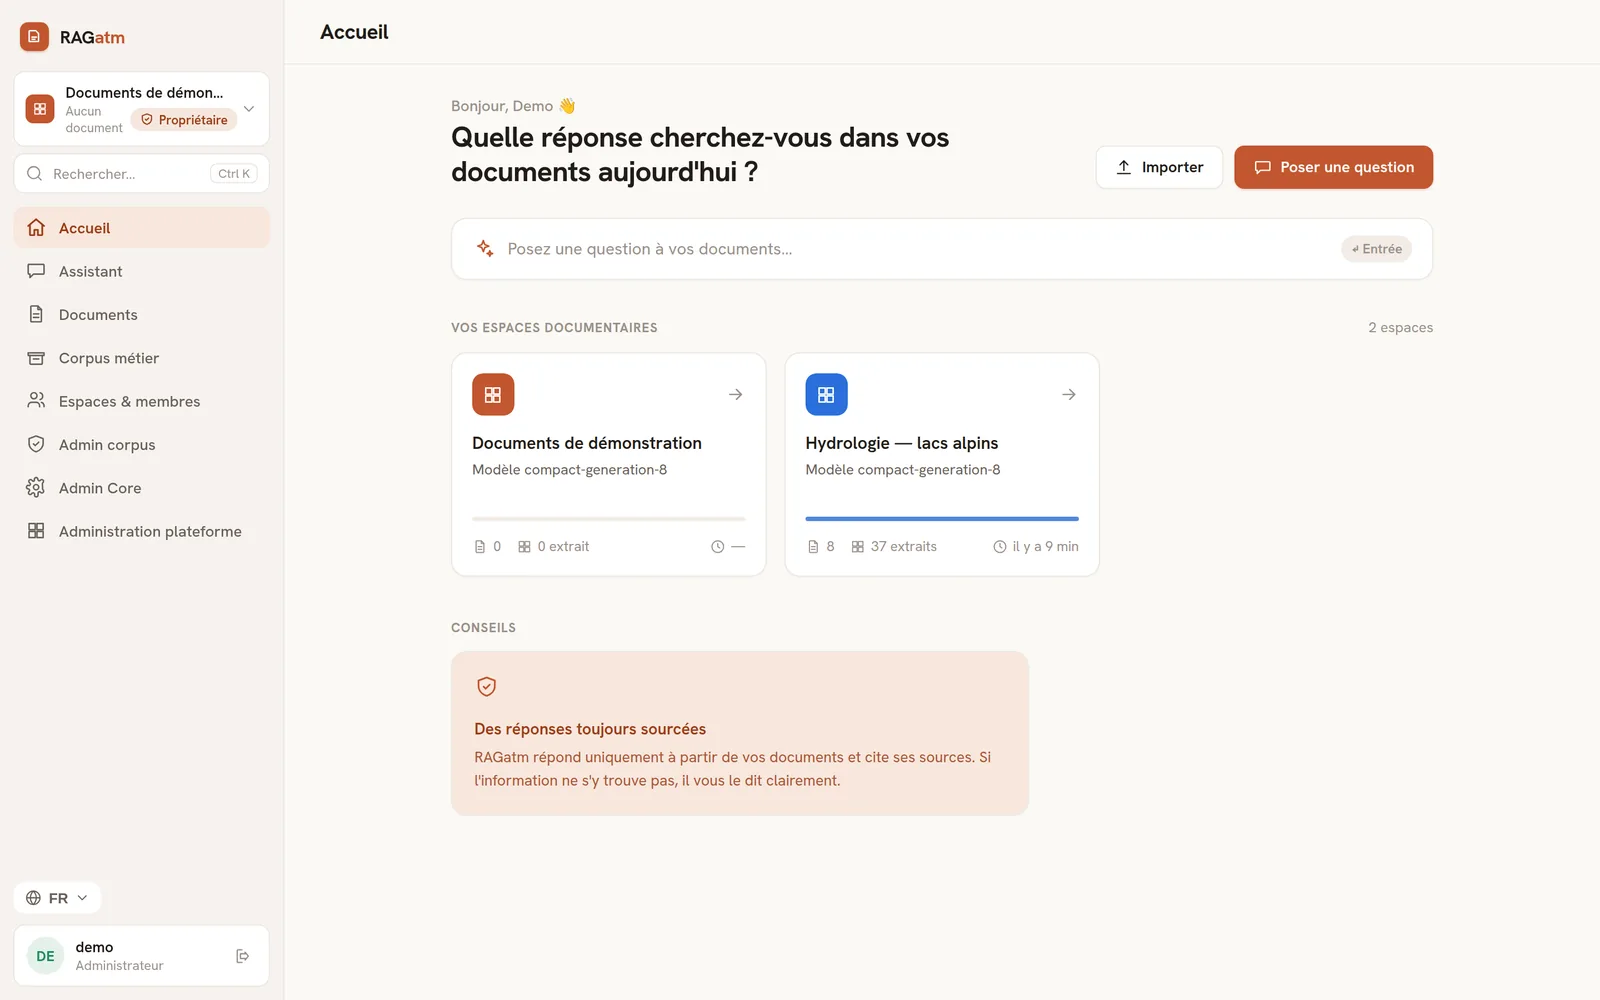
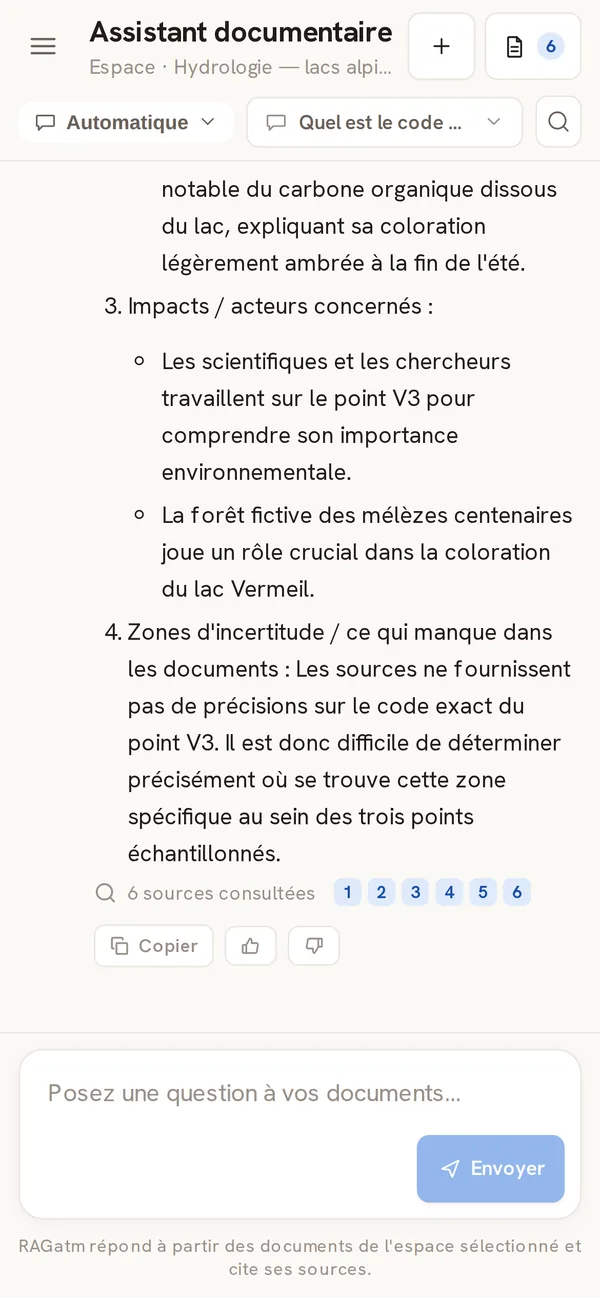
Captures réalisées sur une instance RAGatm Open isolée (édition Open, profil Compact sur CPU, reranker désactivé pour la capture), avec les documents fictifs publiés dans le dépôt et un compte de démonstration.
Le parcours complet est décrit sur la page Architecture.
Déposez vos fichiers dans un espace documentaire cloisonné. Le contenu est validé par sa signature, extrait puis découpé.
Chaque fragment reçoit un vecteur calculé localement et rejoint l’index plein texte de PostgreSQL.
Recherche hybride (mots-clés et vecteurs), puis reclassement par un cross-encoder local.
Un modèle local génère la réponse en flux, avec les sources typées pour chaque affirmation.
Des organisations qui veulent interroger leurs documents sans les confier à un service distant.
Procédures, contrats, rapports, documentation technique.
Recherche et comparaison dans des dossiers volumineux, sur une infrastructure maîtrisée.
Archives, statuts, procès-verbaux, procédures internes.
Notes, publications, collections personnelles.
Déploiement Docker Compose, API, contrats, modules.
Le catalogue recense tous les formats identifiés dans le code, avec un statut vérifié pour chacun.
Statuts évalués pour le profil Compact tel que publié. 44 formats recensés.
Ce que le code publié permet, ce qui est activé par défaut, et ce qui reste de votre responsabilité.
Génération, embeddings et reranking passent par AI Gateway Open, qui n’appelle que des moteurs locaux (Ollama, TEI).
La seule valeur admise pour le repli externe est « none » ; des vérifications au démarrage refusent toute autre configuration.
Réseaux Docker internes, un seul port publié sur la boucle locale, aucune sortie Internet en fonctionnement nominal.
Trois dépôts Apache-2.0, dépendances verrouillées par empreintes, images de base épinglées par digest.
Procédures de sauvegarde et de restauration documentées ; aucun poids de modèle ni donnée ne quitte votre hôte.
Second facteur TOTP obligatoire pour chaque compte, rôles par workspace, espaces isolés.
Logiciel libre sans licence par utilisateur, fonctionnant sur un serveur sans GPU. Projet développé en France, dans une démarche européenne de maîtrise technologique ; aucune certification de souveraineté n’est revendiquée.
Un logiciel auto-hébergé n’est pas « conforme » ou « souverain » par nature : la conformité réglementaire et la sécurité de l’hôte restent la responsabilité de l’exploitant.
Profil Compact sur CPU, pile complète, corpus synthétique de 8 documents et 10 questions.
Une application, une passerelle de modèles, un pool facultatif. Chaque composant a un rôle et un contrat.
ragatm-openPlateforme documentaire locale de questions-réponses sur documents (RAG) : espaces cloisonnés, ingestion asynchrone, recherche hybride + reranking, réponses sourcées, modèles exécutés localement via AI Gateway Open.
ai-gateway-openPasserelle d’inférence locale : génération (agrégée et en flux NDJSON), embeddings à identité de pipeline vérifiée, reranking cross-encoder, registre de modèles strict, erreurs typées, sondes non inférentielles. Aucun fournisseur distant.
ai-gateway-pool-openRouteur HTTP autonome devant une ou plusieurs AI Gateway Open, sans modifier le contrat gateway-api/1.0 : sélection de nœud, disjoncteur, allowlist d’upstreams, affinité de jobs, saturation. Facultatif pour Compact.
Deux dépôts à cloner, un préflight, les modèles à approvisionner, puis une pile hors ligne.
Linux x86_64 · Docker Compose · 8 threads · 14 Go de RAM · sans GPU
git clone https://github.com/ragatm-open/ragatm-open.git
git clone https://github.com/ragatm-open/ai-gateway-open.git   # requis ; placé à côté de ragatm-open/
cd ragatm-open/compact && scripts/preflight.shNon dans la configuration qualifiée : tous les modèles s’exécutent localement et le code publié ne contient aucun repli vers un fournisseur distant.
Non. Le profil Compact est qualifié sur CPU. Les profils GPU sont décrits mais non qualifiés.
Non : les images se construisent localement depuis les sources, avec des images de base épinglées par digest.
Pas dans l’édition Open publiée : l’OCR est une option de construction désactivée, et la passerelle ne contient aucun moteur de transcription.