1. Texte extractible
Les chaînes de caractères présentes dans le fichier (couche texte d’un PDF, annotations d’un DXF).
RAGatm Open est d’abord une plateforme de texte. Le code publié contient des extracteurs pour les images, les PDF numérisés, les dessins techniques, les maquettes et l’audio, mais la plupart sont désactivés ou incomplets dans l’édition Open. Cette page distingue chaque cas.
Pour chaque type de contenu, le site distingue ce que le code produit réellement.
Les chaînes de caractères présentes dans le fichier (couche texte d’un PDF, annotations d’un DXF).
Lignes, polylignes, arcs… Dans l’édition Open, ils sont comptés mais jamais indexés.
Titres, tableaux, diapositives, calques, hiérarchie spatiale IFC : conservés comme blocs typés avec un localisateur pour les citations.
Interpréter un schéma, une légende, une vue 3D. Aucun composant de l’édition Open ne le fait.
Possible uniquement pour les niveaux 1 et 3 ; la réponse cite alors le texte ou la structure, pas le dessin.
Ce que deviennent les images, les PDF numérisés et les descriptions visuelles.
| Fonctionnalité | Statut | Description et limites | Détails |
|---|---|---|---|
| Tableaux natifs (PDF, DOCX, PPTX, XLSX) | Disponible par défaut | PDF : seul le type pile_head_forces est extrait en structuré (toujours actif) ; tableaux PDF génériques sous flag (off) ; DOCX linéarisés « cellule | cellule » ; PPTX en Markdown ; XLSX en chunks structurés avec locator feuille+plage. Tableaux PDF génériques partiels et désactivés ; données de graphiques Office désactivées ; images et graphiques XLSX ignorés. | Détails
|
| DXF : extraction documentaire (texte, attributs) | Disponible avec configuration | ezdxf installé ; annotations TEXT/MTEXT/DIMENSION/MULTILEADER par layout+calque et ATTRIB de blocs ; entités géométriques seulement comptées ; flag fermé par défaut. Texte : oui ; géométrie : comptée, jamais indexée ; structure : calques et blocs ; compréhension sémantique : non ; ancrage RAG : annotations seulement. | Détails
|
| OCR PDF (Tesseract local) | Module optionnel | OCR des pages PDF sans texte via pytesseract + pypdfium2 (fra+eng, auto-rotation, ≤50 pages, 60 s/page) ; off dans le code et en Compact ; image Compact construite sans Tesseract (WITH_OCR=0). Moteur unique sans repli ; texte OCR classé « autre » (jamais preuve numérique) ; sans OCR un PDF numérisé échoue (pdf_scanned_requires_ocr). | Détails
|
| OCR des images autonomes | Module optionnel | Images JPEG/PNG/TIFF/WEBP acceptées et OCRisées systématiquement par Tesseract ; en Compact l’image est acceptée puis échoue ocr_engine_missing. Dans Compact : échec propre, aucun texte extrait des images. | Détails
|
| OCR multilingue | Module optionnel | Langues Tesseract configurables (défaut fra+eng ; image WITH_OCR installe tesseract-ocr-fra/eng). D’autres langues exigent des paquets Tesseract supplémentaires dans une image personnalisée. | Détails
|
| Description d’images par un modèle de vision | Module optionnel | Appel POST /v1/vision/analyze (tâche describe) produisant une description textuelle indexée ; off côté RAGatm et Gateway ; aucun modèle vision au registre Compact ; file ingest_visual sans consommateur en Compact. La description est un texte, pas une extraction de valeurs ; inaccessible dans Compact (aucun modèle de vision). | Détails
|
| Enrichissement visuel des images intégrées | Module optionnel | Découverte des images intégrées PDF/DOCX/PPTX puis description Vision différée ; la découverte PDF exige PyMuPDF (AGPL, non installé) ; DOCX/PPTX jamais qualifiés contre une Gateway réelle. Vision sur images intégrées aux PDF impossible avec l’image Open par défaut. | Détails
|
| DWG via LibreDWG | Module optionnel | Conversion DWG→DXF par l’exécutable GPL dwg2dxf (sous-processus) puis DxfExtractor ; option de build WITH_DWG=1 et worker ingest_dwg ; non construit en Compact. Mêmes limites que le DXF ; exécutable GPL séparé. | Détails
|
| IFC / BIM : extraction sémantique | Module optionnel | Hiérarchie spatiale, éléments, propriétés, quantités, matériaux via ifcopenshell (extra ifc, ~147 Mo) ; aucune géométrie ni coordonnée ; worker ingest_ifc requis ; non construit en Compact. Texte et attributs : oui ; géométrie : non ; 3D : non ; sémantique : attributs du schéma seulement. | Détails
|
| Numérisation de courbes (expérimentation interne) édition privée uniquement | Expérimental | Module expérimental de digitalisation de courbes exécuté en ombre ; rien n’est publié dans l’index. Expérimentation interne dépendant d’un module absent. | Détails
|
| Vision par régions (expérimentation interne) édition privée uniquement | Expérimental | Orchestration V2 (rendu pdfium, rognage de régions) expérimentale, allowlist vide, aucun fragment produit. Expérimentation interne. | Détails
|
| Compréhension de graphiques, schémas et dessins techniques | Non qualifié | Les tâches table/diagram/chart/technical_drawing existent au schéma Gateway mais ne sont pas qualifiées (400 vision_task_not_qualified) ; graphiques et plans ne reçoivent au mieux qu’une description ; aucune valeur de série ni relation structurée. Texte : via description seulement ; géométrie : non ; structure : non ; compréhension sémantique : non ; ancrage RAG : texte de description seulement. | Détails
|
| Service local d’analyse de mise en page (rail hybride) | Non qualifié | Rail hybride vers un service d’analyse de mise en page local (boucle locale), 3 pages par document au maximum ; non qualifié, absent de Compact. Aucune limite particulière relevée. | Détails
|
| Figures vectorielles PDF | Non qualifié | Rendu des régions vectorielles d’un PDF (PyMuPDF) puis description ; drapeau et liste d’espaces autorisés ; extraction visuelle non retenue. Nécessite PyMuPDF, absent de l’image Open. | Détails
|
| Points d’API de vision de la passerelle | Non activé | POST /v1/vision/analyze, GET /v1/vision/capacity, GET /health/vision existent (backend OllamaVisionBackend) ; désactivés (503 vision_not_enabled) ; semantic_extract exclu de l’édition Open. Seule la description est qualifiée ; pas d’OCR dans la passerelle. | Détails
|
| OCR des images intégrées (PDF/DOCX/PPTX) | Non disponible | Aucun OCR n’est appliqué aux images intégrées dans PDF/DOCX/PPTX ; seul le texte alternatif saisi par l’auteur est lu pour les slides. Aucune limite particulière relevée. | Détails
|
| Extraction structurée de mise en page (module externe) édition privée uniquement | Non disponible | Route d’extraction structurée (tableaux → lignes/cellules, graphiques → séries) : client présent dans RAGatm, mais route absente de la passerelle Open (404) et module non inclus. Module d’extraction structurée externe, absent de l’édition Open. | Détails
|
| Géométrie, rendu 3D, légendes | Non disponible | Aucun rendu graphique, aucune géométrie indexée, aucune compréhension de légendes pour les formats CAD/BIM ; les plans/schémas en image ne reçoivent qu’une description Vision (si activée). Aucune limite particulière relevée. | Détails
|
| Format | Statut | OCR | Limites |
|---|---|---|---|
| PDF scanné / image (OCR) | Module optionnel | non | Import accepté (PDF valide) mais ingestion en échec dans Compact (pdf_scanned_requires_ocr). Avec une image reconstruite avec OCR : Tesseract local uniquement, 50 pages maximum, 60 s par page, langues fra+eng ; reconstruction de tableaux par OCR expérimentale et non qualifiée. |
| Image JPEG | Module optionnel | non | Accepté à l’import (DOCUMENT_IMAGE_INGEST_ENABLED=1 par défaut), mais l’extraction repose uniquement sur l’OCR : dans Compact (WITH_OCR=0), l’ingestion échoue avec ocr_engine_missing. Aucune description visuelle par modèle de vision dans l’édition Open. |
| Image PNG | Module optionnel | non | Accepté à l’import (DOCUMENT_IMAGE_INGEST_ENABLED=1 par défaut), mais l’extraction repose uniquement sur l’OCR : dans Compact (WITH_OCR=0), l’ingestion échoue avec ocr_engine_missing. Aucune description visuelle par modèle de vision dans l’édition Open. |
| Image TIFF | Module optionnel | non | Accepté à l’import (DOCUMENT_IMAGE_INGEST_ENABLED=1 par défaut), mais l’extraction repose uniquement sur l’OCR : dans Compact (WITH_OCR=0), l’ingestion échoue avec ocr_engine_missing. Aucune description visuelle par modèle de vision dans l’édition Open. |
| Image WEBP | Module optionnel | non | Accepté à l’import (DOCUMENT_IMAGE_INGEST_ENABLED=1 par défaut), mais l’extraction repose uniquement sur l’OCR : dans Compact (WITH_OCR=0), l’ingestion échoue avec ocr_engine_missing. Aucune description visuelle par modèle de vision dans l’édition Open. |
| Image GIF | Non activé | non | Détecté par signature mais refusé (image_unsupported_format) : absent de la liste DOCUMENT_IMAGE_FORMATS par défaut. L’ajouter à la liste exige en plus une image construite avec OCR. |
| Image BMP | Non activé | non | Détecté par signature mais refusé (image_unsupported_format) : absent de la liste DOCUMENT_IMAGE_FORMATS par défaut. L’ajouter à la liste exige en plus une image construite avec OCR. |
Les tableaux sont extraits de plusieurs formats ; les graphiques ne sont pas reconnus.
| Format | Statut | Tableaux | Mise en page | Limites |
|---|---|---|---|---|
| PDF (couche texte) | Disponible par défaut | partiel | partiel | Moteur pypdf avec repli pdfminer/pdfplumber. 500 pages et 180 s d’extraction au maximum. Tableaux : seuls les types reconnus sont extraits par défaut ; les grilles génériques nécessitent un drapeau et une liste d’espaces autorisés. Images intégrées jamais extraites dans Compact. Les PDF numérisés échouent sans OCR. |
| Word (.docx) | Disponible par défaut | oui | partiel | Corps du document uniquement : en-têtes, pieds de page, notes et zones de texte ne sont pas extraits. Tableaux linéarisés. Images intégrées ignorées. Citations sans numéro de page (format non paginé). |
| Excel (.xlsx) | Disponible par défaut | oui | partiel | Ingestion documentaire uniquement : cellules rendues par fenêtres (40 lignes) avec provenance feuille/plage ; aucun calcul ni évaluation de formule. Limites : 1 000 000 cellules, 100 feuilles, 256 colonnes. Images ignorées. |
| PowerPoint (.pptx) | Disponible par défaut | oui | partiel | Une unité par diapositive (citations par numéro de diapositive). Tableaux rendus en Markdown. Images : seul le texte alternatif saisi par l’auteur est indexé, jamais d’OCR. Notes du présentateur désactivées par défaut. Limite 500 diapositives. |
| CSV | Disponible par défaut | oui | non | Séparateurs virgule, point-virgule ou tabulation. Limites : 100 000 lignes, 256 colonnes, 10 000 caractères par cellule. Une unité « colonne : valeur » par ligne. Aucun calcul tabulaire par défaut. |
| Markdown (.md) | Disponible par défaut | oui | partiel | Reconnu par l’extension .md/.markdown uniquement. Titres, listes, tableaux et blocs de code conservés comme blocs typés ; HTML en ligne neutralisé ; liens jamais suivis. Limite 2 000 000 caractères. |
| HTML | Disponible par défaut | partiel | partiel | Traité comme hostile : scripts, styles, iframes, SVG et formulaires supprimés ; aucune ressource externe chargée. Lignes de tableau aplaties en texte. Limite 2 000 000 caractères. |
Les graphiques (courbes, diagrammes) ne sont pas reconnus : seules les données natives de graphiques Office peuvent être extraites, sous un drapeau désactivé par défaut.
DXF, DWG, IFC : un support documentaire, pas une interprétation graphique.
| Format | Statut | Texte | Géométrie | Métadonnées | Limites |
|---|---|---|---|---|---|
| Dessin DXF (.dxf) | Disponible avec configuration | oui | non | oui | Fermé par défaut (dxf_ingestion_disabled) ; la configuration Compact ne l’ouvre pas. Support documentaire : annotations (TEXT, MTEXT, cotes), attributs de blocs, calques et références déclarées. Les entités géométriques sont seulement comptées : aucune coordonnée indexée, aucun rendu, aucune interprétation du dessin. |
| Dessin DWG (.dwg) | Module optionnel | oui | non | oui | Option de construction désactivée dans Compact (WITH_DWG=0). Conversion en DXF temporaire par LibreDWG (GPL, revue de conformité demandée par la documentation) puis même périmètre documentaire que le DXF ; versions AutoCAD 2000-2018 uniquement. |
| Maquette IFC (.ifc) | Module optionnel | oui | non | oui | Option de construction désactivée dans Compact (WITH_IFC=0) et drapeau fermé. Extraction sémantique uniquement : hiérarchie spatiale, éléments, propriétés, quantités, matériaux ; aucune géométrie, aucun rendu. Nécessite un worker dédié. |
| SVG (texte brut) | Non qualifié | partiel | non | non | Aucun extracteur dédié : le fichier est classé texte brut et indexé tel quel (balises ou structure comprises). Non testé ; résultat de recherche non garanti. |
Le code d’ingestion audio existe ; le moteur de transcription, non.
| Fonctionnalité | Statut | Description et limites | Détails |
|---|---|---|---|
| Ingestion audio et transcription via la passerelle | Module optionnel | Dépôt /documents/upload-audio/ (mp3, m4a, wav, flac, ogg, webm ; ≤600 Mo ; ≤12 h), ffprobe/ffmpeg → FLAC 16 kHz par parties ≤90 min → job ASR asynchrone Gateway (asr-whisper-turbo) ; unités ≤1000 car. avec time_range. Un seul travail ASR en cours par environnement ; taux d’erreur non mesuré ; transcription jamais preuve numérique ; pas de lecteur audio. | Détails
|
| Transcription multilingue | Non qualifié | Langue auto|fr|en au contrat ASR ; langues annoncées fr/en ; qualité non mesurée. Aucune limite particulière relevée. | Détails
|
| Points d’API de transcription (ASR) de la passerelle | Non activé | POST/GET/DELETE /v1/audio/transcriptions (multipart, formats json|text|srt|vtt, language auto|fr|en, diarize, jobs 202) relayés vers un backend faster-whisper externe sur 127.0.0.1:8400 non inclus ; désactivés (503 asr_unavailable). La passerelle ne décode jamais l’audio ; le backend ASR ne fait pas partie de la distribution Open. | Détails
|
| Audio en profil Compact | Non activé | Audio désactivé : WITH_AUDIO=0, DOCUMENT_AUDIO_*=0, AI_GATEWAY_ASR_ENABLED=0, pas de worker ingest_audio ; la qualification E2E attend un refus du dépôt audio. Aucune limite particulière relevée. | Détails
|
| Identification des locuteurs (diarisation) édition privée uniquement | Non disponible | Demandée par RAGatm (diarize=true, ≤4 locuteurs, libellés speaker_00…) et déclarée au vocabulaire du registre Gateway ; le backend (Sortformer) n’est pas inclus. Aucune limite particulière relevée. | Détails
|
Chaque option implique une reconstruction d’image ou un composant supplémentaire, et aucune n’est couverte par la qualification Compact.
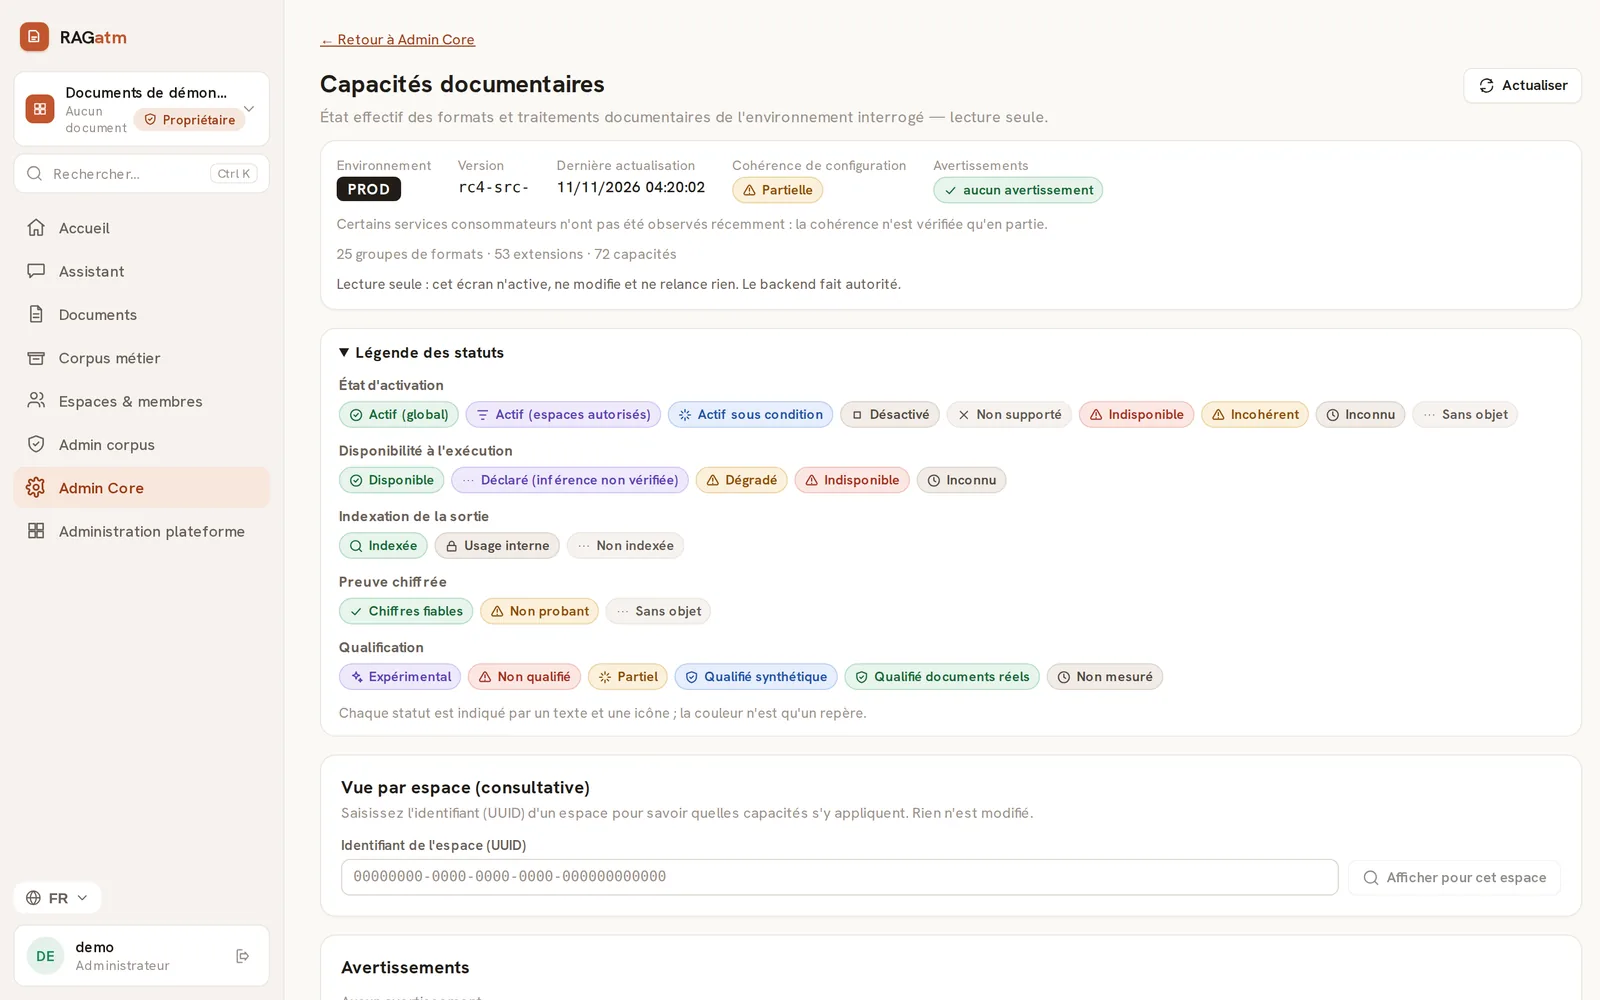
Captures réalisées sur une instance RAGatm Open isolée (édition Open, profil Compact sur CPU, reranker désactivé pour la capture), avec les documents fictifs publiés dans le dépôt et un compte de démonstration.